Um protótipo que funciona é dez por cento de um sistema em produção
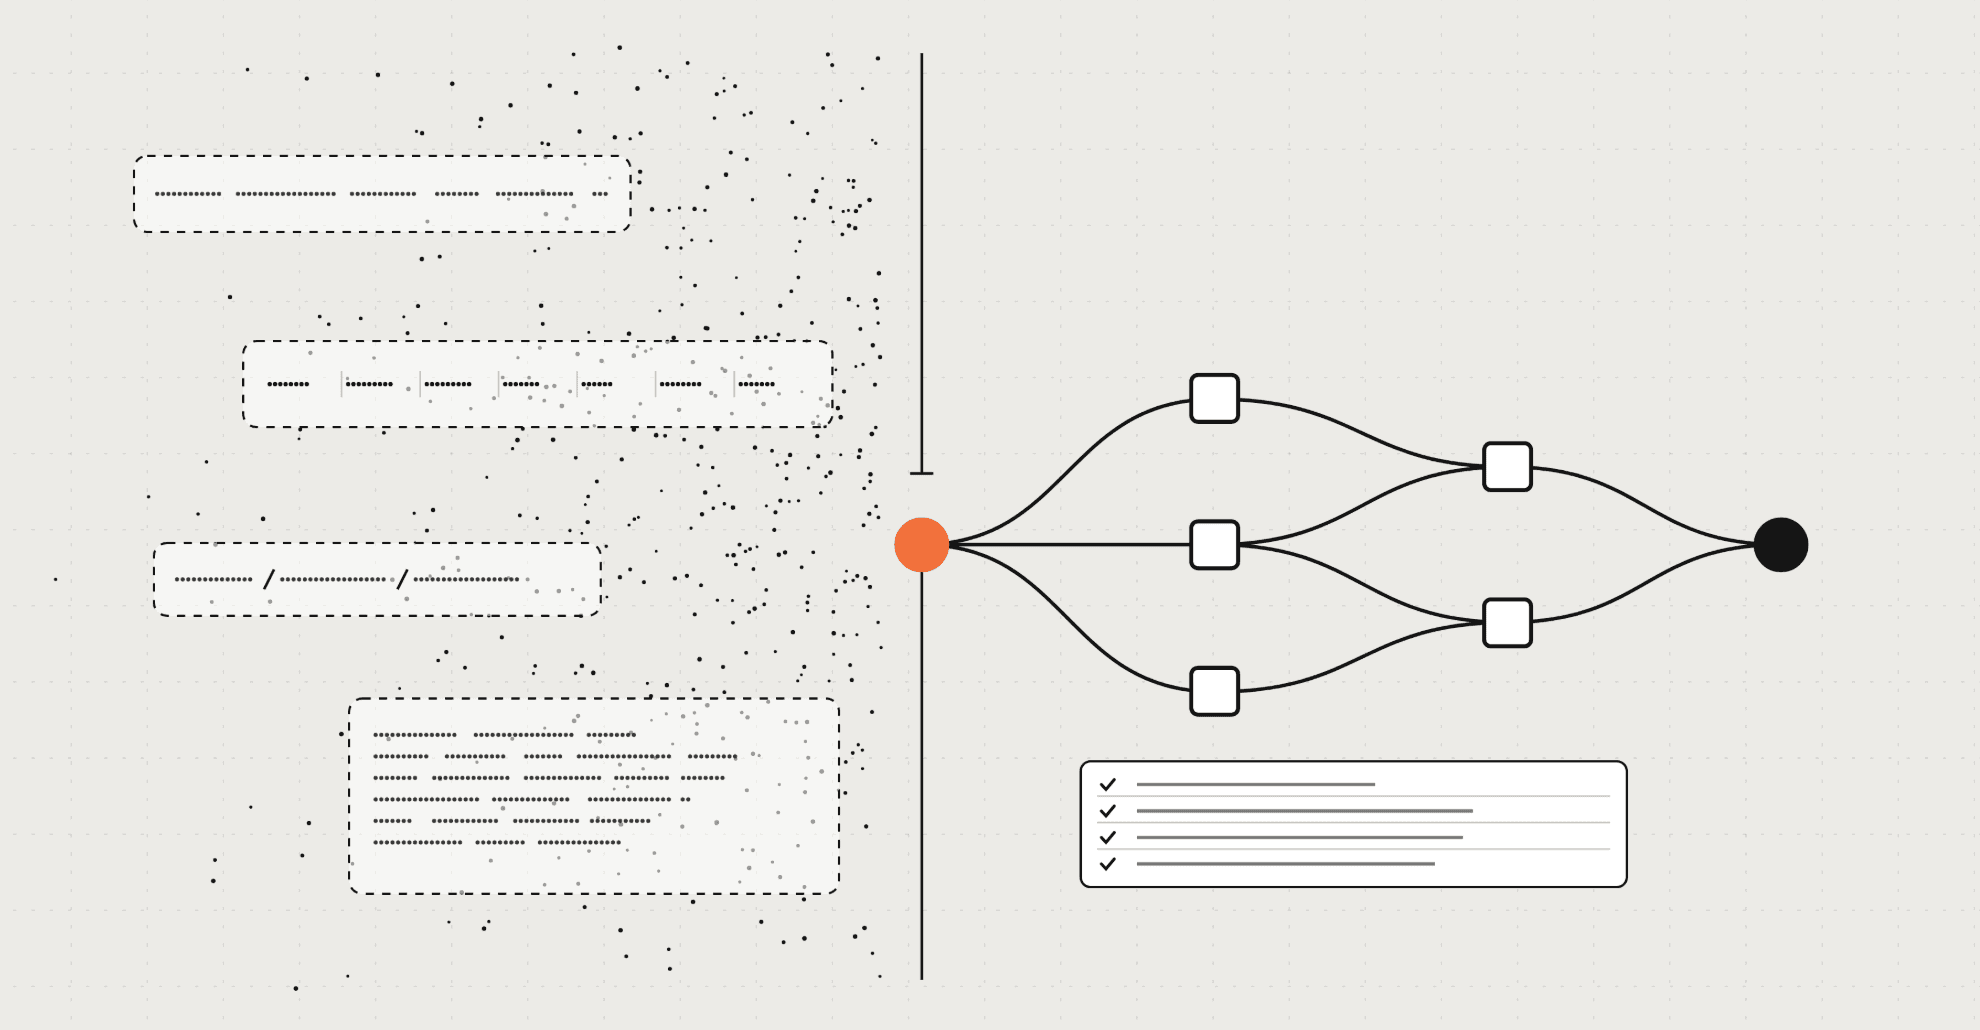
Os modelos de linguagem de grande escala (LLMs), sistemas de IA que escrevem texto e código a partir de instruções em linguagem comum, permitem que uma equipe de tecnologia monte um workflow de operações funcional em uma tarde. A Everysk usa os mesmos LLMs para construir os próprios protótipos. Este artigo mostra o que um protótipo contém, o que ele não consegue revelar e as fases de hardening pelas quais todo workflow da Everysk passa antes que uma instituição dependa dele.
Allan Brik · Outubro 2026
A pergunta que todo líder de tecnologia está fazendo
O CTO de um fundo, de um banco ou de um servidor de crédito pode abrir um assistente de programação baseado em LLM e descrever um processo: ler nossas transações, aplicar estas regras de monitoramento, gravar os alertas em uma tabela. Em poucas horas, o assistente devolve um código que roda com dados de amostra e gera um resultado coerente. A conclusão natural é que o desenvolvimento terminou e que a plataforma ficou dispensável.
O protótipo responde a uma pergunta: essa lógica pode ser escrita? Uma instituição precisa responder a várias outras antes que essa lógica toque o dinheiro de clientes ou um informe ao regulador. O processo termina no prazo com o volume completo? Dá a mesma resposta se o mesmo dia for reprocessado na semana seguinte? Se uma etapa falhar, alguém vai saber? Onde ficam as credenciais, e quem pode alterar um limite? Responder a essas perguntas é a maior parte do trabalho, e um LLM não consegue respondê-las em uma única conversa, porque as respostas dependem de como dados reais e infraestrutura real se comportam.
Como é um protótipo na Everysk
As fases de hardening descritas mais adiante atuam sobre partes específicas de um protótipo, então vale nomear essas partes primeiro. A Everysk executa processos de operações como workflows. Estes são os termos usados no restante do artigo.
Workflow - Um processo dividido em etapas separadas, como ler dados, aplicar regras e gravar resultados. Cada etapa faz uma única tarefa, então cada uma pode ser testada, substituída ou executada de novo de forma independente.
DAG - Grafo acíclico direcionado (directed acyclic graph): o mapa de qual etapa alimenta qual. As setas apontam só para a frente, então o processo tem início e fim claros, e uma etapa só roda quando todas as etapas de que depende terminaram. Etapas que não dependem uma da outra podem rodar ao mesmo tempo.
Worker - Uma etapa do grafo. A Everysk oferece uma biblioteca de workers prontos, que chama de robôs: um recupera uma tabela armazenada, outro lê um arquivo no servidor do cliente, outro converte um relatório em PDF, outro envia uma notificação. Um worker Starter inicia cada execução, e um worker Ender a encerra.
For Developer worker - Um worker cujo conteúdo é código Python. É nele que fica a lógica específica do cliente: uma regra de monitoramento, um score de risco, um método de alocação. É também a parte que um LLM escreve com mais facilidade.
Runtime - O container de processamento em que um worker roda: quanta memória e quantos processadores ele tem, e quais bibliotecas de software estão instaladas. Uma etapa leve roda em um container padrão. Uma etapa pesada recebe um runtime maior, por exemplo com mais memória e um conector de data warehouse instalado.
Datastore - Uma tabela armazenada na plataforma, com nome, data e tags. As etapas leem suas entradas de datastores e gravam neles seus resultados, e a plataforma guarda cada versão datada.
Handshake - O formato combinado em que uma etapa passa os dados para a próxima. Na Everysk, costuma ser uma tabela escrita como lista de linhas, com os nomes das colunas primeiro, que qualquer etapa em Python consegue converter em dataframe e de volta em tabela.
Conectividade - A conexão entre o workflow e os sistemas do próprio cliente: um data warehouse como o Snowflake, um servidor seguro de arquivos, um sistema de gestão de ordens (OMS), um custodiante ou um prime broker.
Secret - Um repositório criptografado de senhas e chaves. Um worker solicita uma credencial por referência no momento da execução, então a credencial nunca aparece no código, em um log ou na definição do workflow.
A Everysk reuniu o seu conhecimento sobre essas partes em skills: conjuntos de instruções, bibliotecas de código e checagens que um LLM carrega antes de começar o trabalho. A skill de construção de workflows recebe uma especificação ou uma planilha de exemplo e faz o que um engenheiro da plataforma faria. Ela decide como dividir o processo em etapas, escreve cada etapa em Python com o handshake correto, gera datastores de amostra, conecta o grafo e organiza o layout para que um revisor consiga lê-lo. Depois, valida o workflow, faz o deploy, executa e confere os resultados. Uma primeira versão de um workflow com trinta etapas pode estar rodando em um dia.

Esse é um artefato real. Ele roda, pode ser demonstrado, e a sua lógica de negócio muitas vezes está correta. Ele também carrega premissas que os dados de amostra nunca testam: que o volume de dados é pequeno, que toda etapa dá certo, que o relógio do servidor indica a data de referência, que uma contagem de linhas igual prova que a carga foi correta e que quem executa é a mesma pessoa que escreveu o código.
O que os dados de amostra não mostram
Os problemas a seguir são comuns tanto em protótipos escritos por LLMs quanto nos escritos à mão. Nenhum deles aparece em uma amostra de alguns milhares de registros, e a maioria passaria por uma leitura atenta do código. Eles só surgem com volume real, com dados reais ou quando o mesmo dia é executado duas vezes.


As fases de hardening
Todo workflow da Everysk é construído em dois estágios: um protótipo que prova a lógica e, em seguida, uma sequência fixa de fases de hardening que o deixa pronto para produção. O protótipo sempre foi a parte curta. A ordem das fases importa: a medição vem antes da otimização, e um teste de equivalência existe antes de qualquer alteração no código, para que cada mudança posterior possa ser comprovada como inofensiva.
1 - Medir
Cada parte de cada etapa ganha um cronômetro: leitura dos dados, avaliação das regras, comparação de nomes, gravação dos resultados. O uso de memória também é registrado. Depois, a etapa roda com um mês e com três meses de dados. Se o tempo cresce cerca de três vezes, a etapa escala na proporção dos dados. Se cresce cerca de nove vezes, alguma parte dela escala com o quadrado dos dados, e os cronômetros mostram qual.
2 - Congelar a resposta
Antes de qualquer otimização, o resultado atual é registrado como um fingerprint, uma espécie de impressão digital do resultado: um hash calculado a partir de cada alerta ou de cada célula de cada tabela de resultado. Qualquer mudança no resultado, por menor que seja, altera o fingerprint. Toda fase seguinte precisa reproduzi-lo exatamente, o que converte a frase “esta mudança não deve afetar os resultados” em um teste verificável.
3 - Remover o comportamento quadrático
Laços que comparam cada item com todos os outros são substituídos por buscas ordenadas e consultas indexadas, cujo custo cresce na proporção dos dados. Na verificação de nomes, cada nome é comparado primeiro apenas com as entradas da lista que compartilham uma palavra suficientemente rara, o que reduz milhões de comparações por dia a poucas por pessoa. O fingerprint confirma que os alertas continuam os mesmos.
4 - Reduzir a complexidade ciclomática
A complexidade ciclomática é a contagem dos caminhos distintos que um trecho de código pode seguir. Cada if, else, laço ou exceção acrescenta um caminho. Uma função sem decisões tem complexidade 1. Uma função que verifica a classe de ativo, depois a moeda e depois se a conta tem restrição já tem vários caminhos, e cada um é um caso que um teste precisa cobrir e um ponto em que uma mudança futura pode quebrar algo sem ninguém perceber. Protótipos tendem a acumular uma única função principal longa que faz tudo, muitas vezes com complexidade de 50 ou mais. Nesta fase, cada função desse tipo é dividida em funções menores, cada uma responsável por uma parte do processo, com meta de complexidade 10 ou menos. O resultado é um código que um revisor lê de uma só vez e que uma suíte de testes consegue cobrir por completo.
5 - Revisar o design com base nos princípios SOLID
A baixa complexidade torna cada função legível. O SOLID trata de como as funções se encaixam, para que o sistema possa mudar sem quebrar. É um conjunto de cinco princípios de design amplamente usado na engenharia de software profissional. Em termos simples:
Responsabilidade única. Cada componente tem um único motivo para mudar. O código que lê os pagamentos fica separado do código que decide quais pagamentos são suspeitos, porque uma troca de fonte de dados nunca deve afetar a lógica de monitoramento.
Aberto para extensão, fechado para modificação. Adicionar algo novo não deve exigir a edição do que já funciona. Um novo tipo de regra entra por registro, sem acrescentar mais um desvio a uma longa cadeia de condições pela qual todas as regras existentes passam.
Partes substituíveis. Qualquer componente que se propõe a fazer uma tarefa precisa funcionar em qualquer lugar onde essa tarefa seja necessária. Um leitor de arquivo de teste e um leitor do data warehouse do cliente precisam devolver tabelas no mesmo formato, para que o motor não consiga diferenciá-los.
Interfaces enxutas. Um componente depende só do que usa. Uma etapa de pontuação que precisa de três colunas recebe essas três colunas, sem exigir o cadastro completo do cliente.
Dependência de contratos. O motor de monitoramento recebe uma função que lê uma tabela e desconhece a origem dessa tabela: um datastore, um arquivo ou o Snowflake. É isso que permite que o mesmo motor, já testado, passe dos dados de amostra para os sistemas do cliente sem nenhuma mudança na sua lógica.
A revisão é feita sobre o código, princípio por princípio, e cada achado é corrigido e verificado de novo contra o fingerprint.
6 - Dividir o trabalho onde a lógica permite
O trabalho que ainda ultrapassaria o limite de tempo de uma etapa é dividido entre workers em paralelo. A lógica do processo define a divisão. Se cada regra olha um cliente por vez, dividir por cliente dá resultados idênticos. Dividir por data mudaria os resultados, porque uma regra que conta pagamentos em trinta dias pode atravessar a fronteira entre dois lotes. Uma etapa de planejamento registra o plano, cada lote grava em uma tabela de staging, e uma etapa de consolidação só publica quando todos os lotes informam conclusão sob o mesmo plano e o resultado combinado confere com o fingerprint.
7 - Tornar toda falha visível
Cada etapa grava um registro do que gravou e para se algo falhar, então toda falha fica registrada e interrompe a execução. Cada estágio grava um marcador de conclusão como última ação, e o estágio seguinte começa verificando se o marcador existe e se cada tabela listada nele tem o número de linhas declarado. Checagens independentes recalculam os principais totais a partir da origem, sem confiar na etapa que os produziu, e a execução falha se qualquer gravação, em qualquer ponto, tiver falhado.
8 - Conectar aos dados do cliente com segurança
Os datastores de amostra são substituídos por leituras diretas dos sistemas do cliente, na maioria das vezes um data warehouse. As consultas têm ordenação explícita para que os resultados sejam reproduzíveis, os formatos numéricos seguem as definições de coluna do próprio warehouse, e o volume de histórico lido é calculado a partir dos períodos de análise configurados nas próprias regras. Cada carga é conferida valor a valor, além da contagem de linhas. As credenciais ficam em Secrets e guardam só o que precisa ser sigiloso. Endereços e configurações são parâmetros comuns, com controle de versão. O perfil de acesso ao banco de dados é reduzido ao mínimo de que o processo precisa.
9 - Transformar política em dado governado
Limites de alerta, níveis de severidade, limites operacionais e pontos de corte de correspondência saem do código e vão para tabelas de parâmetros com data de vigência. Uma mudança exige a aprovação de uma segunda pessoa, e cada execução registra qual versão de cada parâmetro usou. Uma checagem confirma que todo parâmetro configurado é de fato lido pelo código. Exemplos resolvidos, com respostas conhecidas, ficam armazenados como casos de aceite, e cada execução se avalia contra eles.
10 - Operar
O workflow é agendado pela data de referência, retoma um trabalho dividido do ponto em que parou, publica um status que a equipe de operações consegue ler e guarda os resultados datados conforme uma regra de retenção definida. Um runbook (manual de operação) explica o que significa cada mensagem de falha e o que fazer em cada caso.

O que muda entre os dois
A tabela coloca lado a lado um protótipo e a sua versão de produção. A primeira linha é a parte que um LLM escreve em uma tarde. O restante da tabela é o trabalho das fases de hardening.
Aspecto | Protótipo | Produção |
|---|---|---|
Lógica de negócio | Correta com dados de amostra | A mesma lógica, comprovada idêntica pelo fingerprint após cada mudança |
Volume | Milhares de registros | Milhões de registros, com tempo de execução e memória medidos por etapa |
Tempo de execução | Pode crescer com o quadrado dos dados | Cresce na proporção dos dados; trabalhos longos são divididos entre workers em paralelo |
Estrutura do código | Uma função longa com muitos caminhos | Funções pequenas, de baixa complexidade, revisadas com base no SOLID |
Falha | Reportada como mensagem; a execução continua | Registrada e interrompe a execução; marcadores de conclusão e checagens de entrada entre estágios |
Reprodutibilidade | Depende do relógio do servidor e do histórico de execução | Vinculada à data de referência; reprocessar um dia dá a mesma resposta |
Dados | Tabelas de amostra | Lidos diretamente dos sistemas do cliente e conferidos valor a valor |
Credenciais | Muitas vezes no código | Em Secrets criptografados, com o perfil de acesso mais restrito que funciona |
Política | Constantes no código | Tabelas de parâmetros datadas, com aprovação de duas pessoas e uma versão por execução |
Comprovação | O resultado parece correto | Casos de aceite avaliados em cada execução; checagens independentes recalculam os totais |
Operação | Executado pelo próprio autor | Agendado, retomável, monitorado e com runbook para cada falha |
Por que isso pesa na decisão entre construir e contratar
Nenhum dos problemas acima é raro, e nenhum exige habilidade fora do comum para ser corrigido depois de encontrado. A dificuldade está em encontrá-los. Eles aparecem quando um sistema roda com volume real, com dados reais, mais de uma vez, e as respostas são comparadas. Vários dependem de características de uma infraestrutura específica que não estão documentadas em lugar nenhum: onde fica um limite de memória, qual o tamanho máximo de tabela que uma camada de armazenamento aceita, o que um processo informa quando o processo que ele chamou falha, como um método de carga específico trata uma coluna de data.
Um LLM acelera os primeiros dez por cento. Os outros noventa por cento são conhecimento acumulado sobre onde sistemas reais quebram.
Na Everysk, esse conhecimento fica registrado nas skills, nas bibliotecas de código compartilhadas e nas checagens automáticas que todo workflow herda. Cada implantação em produção acrescenta algo a elas, então o próximo protótipo já começa com as lições de todos os anteriores e chega à produção mais rápido.
Uma equipe interna pode seguir o mesmo caminho, e algumas devem. A comparação justa coloca a plataforma frente a frente com os meses de medição, falha e correção que transformam o resultado de uma tarde com um LLM em algo em que reguladores, auditores e clientes podem confiar, somados aos anos de manutenção que mantêm o sistema nesse nível.